Manejo de errores
Reintentar la creación de generaciones
Para POST /v2/generate, envía una Idempotency-Key en el primer intento y reutilízala con el mismo payload en cada reintento. La guía cubre las respuestas reproducidas, los conflictos de payload, la retención y todos los errores IDEMPOTENCY_*. Una respuesta perdida o IDEMPOTENCY_OUTCOME_UNKNOWN no autoriza a usar una clave nueva ni a reintentar sin clave. Una respuesta desconocida puede incluir generationId; haz polling de ese ID cuando esté disponible.
Sin una clave, un timeout o un fallo de transporte al crear puede dejar en duda si el request fue aceptado. Confirma el resultado antes de volver a enviarlo. Los consejos generales de backoff que aparecen más abajo no hacen que repetir una creación sin clave sea seguro.
Códigos de estado HTTP
Al llamar a la API de sync. labs, puedes encontrarte con los siguientes códigos de estado HTTP. Se devuelven a nivel HTTP, antes de cualquier código de error específico de la generación.
HTML 403 o Cloudflare Access denied
Si un request a api.sync.so devuelve una página HTML que identifica a Cloudflare con HTTP 403, Access denied o el error 1010, trátalo por separado de los errores JSON de la API que se describen más abajo. Un bloqueo de Cloudflare puede ocurrir antes de la validación de la API, así que por sí solo no demuestra que tu API key, tu plan o tu media no sean válidos.
Deja de reintentar y contacta a support@sync.so con el método y el endpoint del request, el timestamp en UTC, el Ray ID de Cloudflare, la versión de tu cliente/SDK y una respuesta o captura de pantalla con los datos sensibles ocultos. Para subidas, incluye el content type y los tamaños de los archivos. No envíes API keys, headers de autorización ni URLs de media firmadas. Soporte necesita la respuesta concreta para investigar; no asumas que todos los 403 tienen la misma causa.
Un 403 de una URL de subida prefirmada a storage es un caso distinto: revisa la guía de solución de problemas de Asset Uploads para comprobar el content type y la expiración de la URL.
Códigos de error legibles por máquinas
Cada generación fallida incluye un errorCode estable y legible por máquinas junto al mensaje error legible por humanos. El errorCode aparece tanto en la respuesta de Get Generation (GET /v2/generate/{id}) como en el webhook payload que se entrega cuando termina un job.
Basa tu manejo de errores en errorCode, no en el texto de error. El mensaje error está pensado para personas y puede cambiar de redacción con el tiempo; el errorCode es un identificador estable sobre el que puedes hacer un switch en tu código con seguridad.
Una generación fallida se ve así:
Las respuestas de error de los endpoints de requests (assets, voces, TTS y rechazos de generate al momento del envío) tienen la misma forma legible por máquinas, con dos campos opcionales adicionales: field indica el campo del request que causó el fallo (por ejemplo voiceId o input[].assetId) y docsUrl enlaza a la página de documentación correspondiente. Los 500 no manejados incluyen un requestId que puedes darle a soporte, junto con errorCode: internal_error:
Consulta cualquier código en el catálogo de errores
GET /v2/errors devuelve el catálogo completo de códigos de error (los códigos de generación más los códigos de requests de la API que aparecen más abajo) como un array de objetos { code, message, suggestion }. El endpoint no requiere autenticación (no hace falta el header x-api-key), así que puedes resolver cualquier errorCode a su significado y a una solución sugerida en tiempo de ejecución.
Una entrada típica se ve así:
Lee y resuelve un código de error
Cuando una generación falla, lee su errorCode y búscalo en el catálogo que devuelve GET /v2/errors.
Errores al validar la solicitud
Algunos requests se rechazan al momento del envío: la API responde con un error en el propio request, antes de que empiece cualquier render, en lugar de aceptar el job y hacerlo fallar más tarde. Estos rechazos devuelven un estado HTTP y un errorCode legible por máquinas en el body de la respuesta, para que puedas corregir el request y volver a enviarlo sin desperdiciar una generación.
Un error al momento del envío devuelve errorCode en la respuesta HTTP. Los fallos de validación pueden ocurrir antes de crear la generación, pero un envío con resultado incierto puede tener ya una generación. Haz polling de generationId cuando se proporcione y sigue la guía de recuperación de idempotencia antes de reintentar.
Los errores de rate limit y de dependencias (429/503/504) también reflejan su guía de reintento en headers: Retry-After (segundos) y, para los 429 de concurrencia, X-Sync-Concurrency-Limit y X-Sync-Active-Generations.
Códigos de error de requests de la API
Además de los fallos de generación, los endpoints de assets, voces, TTS y descarga de generaciones devuelven sus propios valores estables de errorCode en las respuestas de error. Cuando corresponde, el body también incluye field (el campo del request que causó el error) y docsUrl (un enlace a la página de documentación correspondiente). Todos aparecen en el catálogo de errores (GET /v2/errors).
Assets
Voces y TTS
Descargas
GET /v2/generations/{id}/download devuelve una URL para descargar el output de una generación completada. Las generaciones inexistentes, eliminadas o de otra organización devuelven generation_not_found (404), como se explicó antes. Una API key ausente, no válida o revocada devuelve 401, y un id que no es UUID devuelve 400. Los códigos específicos de descarga son:
Capacidad de subida de batches
Una subida de batch multipart puede devolver 503 con errorCode: upload_capacity_unavailable. No se creó ningún batch. Reintenta el mismo request después de los segundos indicados en Retry-After. También puedes enviar los registros como un body JSON con rows.
Recortes de audio
POST /v2/audio-trims y GET /v2/audio-trims/{id} preparan un asset de audio más corto para un video parcial. Estos códigos no están en el catálogo de errores.
Un recorte que no puede decodificar o cortar el audio termina con status: failed y errorCode: audio_trim_failed en GET /v2/audio-trims/{id}. Comprueba que la fuente sea un archivo de audio legible y luego inicia un recorte nuevo con una Idempotency-Key nueva.
Reutilizar una Idempotency-Key con un body distinto devuelve 409. Una Idempotency-Key ausente, o una que no tenga entre 1 y 128 caracteres de [A-Za-z0-9._~-], devuelve 400. Una fuente de audio o un recorte que no existe o al que no tienes acceso devuelve 404. Sube primero las fuentes externas y recórtalas por assetId.
Generaciones rechazadas y fallidas
REJECTED y FAILED son estados finales. Revisa errorCode y error en la respuesta de la generación o en el webhook. REJECTED significa que el request o la cuenta necesitan una corrección antes de otro intento. FAILED significa que el procesamiento se detuvo por un error operativo. Sigue la recuperación indicada para el código devuelto y contacta a soporte si persiste.
NO_OP también es un estado final: la generación terminó, pero no se sincronizaron los labios en ningún frame, así que el output es el video de entrada sin cambios. Incluye uno de los códigos de lip sync omitido. Consulta Finished without lip sync.
Un request rechazado antes de que exista una generación devuelve su error en la respuesta HTTP. Deja de hacer polling cuando una generación llegue a cualquier estado final (COMPLETED, NO_OP, FAILED o REJECTED). Para los reintentos, sigue Idempotent requests.
¿Qué significan los códigos de error de la API?
Los códigos de abajo están agrupados por categoría, primero los más comunes.
Errores de validación de entradas
generation_unsupported_model
Mensaje: “The requested model is not supported for this operation.”
Descripción: Este error se produce cuando intentas usar un modelo que no es compatible con la operación o el endpoint de la API actual.
Solución:
- Consulta la documentación de modelos para ver qué modelos admite esta llamada concreta a la API.
- Actualiza tu request para usar un modelo compatible.
- Si crees que se trata de un error, contacta a nuestro equipo de soporte con los detalles de tu caso de uso.
generation_plan_duration_exceeded y generation_model_duration_exceeded
Mensaje: “The input exceeds your plan’s output-duration limit.” o “The input exceeds the selected model’s duration limit.”
Descripción: No hay un límite fijo de duración de audio para el lip sync. El output más largo que puedes generar depende de tu plan (consulta Billing), y algunos modelos tienen su propio tope, como 15 segundos para react-1. Un rechazo al momento del envío devuelve 402 generation_plan_duration_exceeded, descrito en Errores al validar la solicitud.
Solución:
- Recorta o divide la media para que el output entre en el límite.
- Si es un límite del modelo, elige un modelo con un límite mayor (consulta List Models).
- Si es un límite del plan, mejora tu plan para tener generaciones más largas.
Los scripts de texto a voz se validan cuando los envías: script acepta de 1 a 5,000 caracteres. Consulta Text-to-Speech.
generation_input_validation_failed
Mensaje: “Something in your input is invalid. Please check your media and settings, then try again.”
Descripción: Este error ocurre cuando los datos de entrada proporcionados no cumplen los criterios de validación necesarios para el procesamiento. Las causas comunes son una URL de entrada o un assetId que no corresponde a media descargable, o media en un formato no compatible.
Solución:
- Revisa tus datos de entrada para asegurarte de que cumplen todos los requisitos y especificaciones de la API.
- Comprueba que todos los campos obligatorios estén presentes y con el formato correcto.
- Verifica que los formatos de archivo, los tamaños y los demás parámetros estén dentro de los límites aceptables.
- Si el problema persiste, contacta a nuestro equipo de soporte con los detalles de tus datos de entrada para recibir más ayuda.
generation_input_audio_invalid
Mensaje: “We could not read the audio file metadata. Please try a different audio file.”
Descripción: Este error ocurre cuando faltan los metadatos del archivo de audio o no se pueden leer. El código equivalente para video es generation_input_video_invalid, que puedes resolver de la misma forma volviendo a codificar a MP4 H.264. Las causas típicas son archivos de audio corruptos, headers dañados o archivos de herramientas que generan metadatos no estándar.
Solución:
- Vuelve a codificar tu archivo de audio con una herramienta estándar como FFmpeg para asegurar que los metadatos tengan el formato correcto:
- Verifica que tu archivo de audio se abra y se reproduzca correctamente en un reproductor multimedia.
- Comprueba que el archivo de audio no se haya corrompido durante la descarga o la transferencia.
- Si el problema persiste, convierte tu audio a otro formato compatible (WAV, MP3, OGG, FLAC) y vuelve a enviarlo.
generation_input_face_selection_invalid
Mensaje: “We could not use the selected speaker face for this video. Please select the face again or try auto-detect.”
Descripción: Este error ocurre cuando el rostro del hablante seleccionado manualmente no se puede usar para la generación. Es posible que el rostro seleccionado no se detecte en el video, que las coordenadas del rostro proporcionadas queden fuera del frame del video o que la selección del hablante activo no sea válida.
Solución:
- Vuelve a ejecutar la detección de rostros y selecciona de nuevo al hablante, asegurándote de que el rostro se vea claramente en el frame elegido.
- Verifica que las coordenadas o los bounding boxes proporcionados manualmente estén dentro de las dimensiones del video.
- Como alternativa, desactiva la selección manual del hablante para que el sistema detecte automáticamente al hablante activo y vuelve a enviar el request.
Errores de la Batch API
Los errores de validación de batches son respuestas 400 que solo incluyen un message; no tienen errorCode. Los rechazos por acceso, plan y capacidad usan los códigos que aparecen a continuación. Los dry runs requieren la misma aprobación de la organización y el mismo plan que la creación de batches.
El acceso a batch no está habilitado (batch_access_not_enabled)
Estado: 403
Descripción: Tu organización no ha sido aprobada para crear batches. El acceso está deshabilitado por defecto, incluso para las suscripciones Scale nuevas. Los dry runs requieren la misma aprobación. Los batches existentes siguen procesándose y se pueden seguir consultando cuando se retira el acceso de creación.
Solución: Contacta a support@sync.so para solicitar acceso para tu organización. Mejorar el plan no habilita el acceso automáticamente.
Batch requiere el plan Scale (plan_feature_unavailable)
Estado: 402
Descripción: La Batch API requiere la aprobación de la organización y un plan Scale o superior (Scale, Enterprise y planes de partners y programas). Los demás planes y las cuentas gratuitas no pueden crear batches. El body incluye requiredPlan y una billingUrl: requiredPlan es scale, o enterprise en los planes de créditos, porque ningún plan de créditos self-serve incluye batch.
Solución:
- Mejora tu plan a Scale, o contacta a ventas por Enterprise, y solicita la aprobación de tu organización para usar la Batch API.
- Para ejecutar unas pocas generaciones a la vez sin batch, envía requests
POST /v2/generateen paralelo dentro de tu límite de concurrencia. Consulta When to use batch, and when not to.
Límite de concurrencia de batches (concurrency_limit_reached)
Estado: 429, con los headers Retry-After y X-Sync-Concurrency-Limit
Mensaje: “Batch concurrency limit reached. You have X active batches and your plan allows Y. Please wait for existing batches to complete or upgrade your plan for higher limits.”
Descripción: Ya estás ejecutando tantos batches como permite tu plan. Cada batch activo ocupa un espacio de un límite de batches igual al límite de concurrencia de tu plan. El body incluye activeBatches, concurrencyLimit y retryAfterSeconds.
Solución:
- Espera
retryAfterSecondso hasta que termine un batch activo. - Revisa tus batches activos con
GET /v2/batch.
Mensajes al validar el batch
Los números de línea cuentan los registros no vacíos; con un body JSON con rows, la línea N es rows[N-1].
Rechazos de filas de edición de diálogo
Ejemplo: {"statusCode": 422, "errorCode": "dialogue_edit_not_found", "lineNumber": 3, "message": "Record at line 3: The dialogue edit was not found in this organization."}
Descripción: Las filas de batch que incluyen dialogueEdit (acceso anticipado) se comprueban al enviarlas, también con dry_run. Si una fila no se puede renderizar, no se crea ningún batch. La respuesta incluye el mismo errorCode que devuelve POST /v2/generate para esa vista previa, como dialogue_edit_not_found, dialogue_edit_not_completed, dialogue_edit_source_mismatch o dialogue_edit_batch_mixed_sources, más el lineNumber de la primera fila que falla. Los números de línea cuentan los registros no vacíos; con un body JSON con rows, la línea N es rows[N-1]. Los demás errores de registros del batch, como un JSON no válido, indican la línea solo en message.
Solución:
- Busca la fila en
lineNumbery corrígela como se describe en Dialogue edit refusals. - Vuelve a validar con
dry_runhasta que la respuesta sea{"status": "VALIDATED"}.
Lip sync omitido
Estos códigos llegan con el estado NO_OP. La generación terminó y su outputUrl es el video de entrada sin cambios, más cualquier voz generada o audio doblado. El lip sync no se cobra. Consulta Finished without lip sync.
generation_lipsync_skipped_no_face
Mensaje: “No face was detected in the video, so nothing was lip-synced.”
Solución: Usa un video en el que el rostro del hablante se vea claramente y con un tamaño suficiente en el frame, y vuelve a enviarlo.
generation_lipsync_skipped_speaker_not_found
Mensaje: “No face was found at the selected speaker position, so nothing was lip-synced.”
Solución: Selecciona un punto en el rostro del hablante en un frame donde sea visible, o usa la detección automática del hablante, y vuelve a enviarlo.
generation_lipsync_skipped_no_active_speaker
Mensaje: “Automatic speaker detection found no one speaking, so nothing was lip-synced.”
Solución: Selecciona tú mismo al hablante con un número de frame y coordenadas, y vuelve a enviarlo. Consulta Speaker Selection.
generation_lipsync_skipped
Mensaje: “No frames were lip-synced, so the video is unchanged.”
Solución: Usa un video en el que el rostro del hablante se vea claramente y vuelve a enviarlo.
Errores del sistema y de procesamiento
generation_pipeline_failed
Mensaje: “The generation failed while processing. Please try again or contact support if this keeps happening.”
Descripción: Este error indica un fallo en uno de los pasos internos de procesamiento del pipeline de generación.
Solución:
- Revisa tus datos de entrada para asegurarte de que cumplen todas las especificaciones requeridas.
- Vuelve a enviar el request, ya que algunos errores del pipeline pueden ser temporales.
- Si el problema continúa, contacta a nuestro equipo de soporte con los detalles de tu request y el mensaje de error concreto para que lo investiguemos.
generation_unknown_error
Mensaje: “Something went wrong while processing this generation. Please try again.”
Descripción: La generación falló por un motivo que no tiene un código más específico.
Solución:
- Reintenta la generación.
- Si falla repetidamente, contacta a soporte con el ID de la generación.
generation_infra_storage_error
Mensaje: “An error occurred while accessing the storage on infra layer.”
Descripción: Este error indica un problema al acceder a los recursos de storage o al gestionarlos durante el proceso de generación. Puede ocurrir por problemas temporales del servicio de storage o problemas de conectividad.
Solución:
- Reintenta tu request tras una breve espera, ya que los errores de storage suelen ser temporales.
- Asegúrate de que tus archivos de entrada sean accesibles y no estén corruptos.
- Si el problema persiste, contacta a nuestro equipo de soporte, ya que puede indicar un problema de infraestructura más amplio.
generation_infra_resource_exhausted
Mensaje: “The infra resources are exhausted.”
Descripción: Este error ocurre cuando los recursos de infraestructura necesarios para procesar tu request no están disponibles temporalmente o están al límite de su capacidad.
Solución:
- Espera unos minutos y reintenta tu request, ya que la disponibilidad de recursos varía.
- Considera enviar tu request en horas de menor demanda, cuando hay más recursos disponibles.
- Si te encuentras con este error con frecuencia, contacta a nuestro equipo de soporte para hablar de tus patrones de uso y de posibles soluciones.
generation_infra_service_unavailable
Mensaje: “The infra service is unavailable.”
Descripción: Este error indica que uno o más servicios de infraestructura necesarios para el procesamiento no están disponibles temporalmente. Puede deberse a mantenimiento, problemas de conectividad o caídas del servicio.
Solución:
- Revisa nuestra página de estado para ver si hay problemas del servicio en curso o ventanas de mantenimiento.
- Reintenta tu request tras una breve espera, ya que los problemas de disponibilidad del servicio suelen ser temporales.
- Si el servicio sigue sin estar disponible durante un periodo prolongado, contacta a nuestro equipo de soporte para recibir actualizaciones y ayuda.
Consejos generales para solucionar problemas
- Revisa tu API key: asegúrate de usar la API key correcta y de que no esté revocada.
- Verifica el formato del request: comprueba que tu request a la API tenga el formato correcto e incluya todos los parámetros obligatorios.
- Revisa los rate limits: asegúrate de no haber superado los rate limits de tu API.
- Consulta el estado del servicio: visita nuestra página de estado para ver si hay problemas del servicio en curso.
- Consulta la documentación: es posible que nuestra documentación de la API se haya actualizado con información nueva o cambios.
Reporta un error poco claro o un workaround
Si un error no indicaba qué corregir, un resultado era incorrecto o necesitaste un workaround, repórtalo con Submit Feedback (POST /v2/feedback).
- Envía un reporte por problema con un
kind(confusing_error,bug,missing_capability,workaround,docsuother) y unmessagede hasta 4,000 caracteres que incluya el texto exacto del error. - Agrega el
errorCodey elgenerationIdcuando los tengas. - El equipo de sync. revisa los reportes a diario.
- La llamada devuelve
202con unidde referencia, no modifica ni reintenta ningún job y está limitada a 30 reportes por minuto. - El servidor MCP expone el mismo reporte como la herramienta
feedback_send.
Cómo encontrar IDs de generación en Studio
Si necesitas encontrar el ID de una generación para solucionar un problema, puedes localizarlo fácilmente desde la interfaz de Studio. Los modos Studio Pro y Studio Lite siguen el mismo proceso básico:
En el modo Studio Pro: primero haz clic en el botón History de la interfaz de Studio y luego sigue los pasos de abajo.
En el modo Studio Lite: ve directamente a los pasos de abajo.
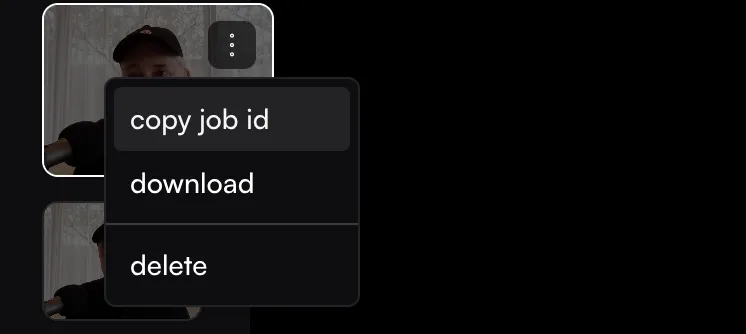
- Localiza tu generación: busca la miniatura de la generación cuyo ID necesitas
- Abre el menú: pasa el cursor sobre la miniatura de la generación y haz clic en el menú de tres puntos que aparece
- Copia el Job ID: selecciona copy job id en el menú desplegable
En el modo Agent: en el modo Agent puedes encontrar los IDs de generación de dos formas:
- Barra lateral de sesiones: haz clic en el menú desplegable (tres puntos) junto a cualquier sesión de la barra lateral y selecciona Copy Job ID
- Tarjeta de error: cuando una generación falla, haz clic en el botón Copy Job ID directamente en la tarjeta de notificación del error
Luego puedes usar este ID de generación al contactar a soporte o al hacer llamadas a la API para obtener los detalles de una generación concreta.
Si sigues teniendo problemas después de probar estos pasos, consulta la página de Troubleshooting para ver problemas comunes y sus soluciones, o contacta a nuestro equipo de soporte para recibir ayuda.
Recursos relacionados
- Rate Limits: entiende el rate limiting de la API y cómo manejar los requests limitados
- Webhooks: recibe notificaciones en tiempo real cuando los jobs de generación se completan o fallan
- Inicio rápido: empieza a usar la API de sync. labs con tu primera llamada
Base de conocimiento de soporte
- Internal Server Error durante el lipsync: solución de problemas de fallos del pipeline
- Internal Server Error durante TTS: errores específicos de TTS
- Solución de problemas de subidas: errores de subida de archivos
- Unable to process audio: errores de procesamiento de audio
- Unexpected error occurred: solución de problemas de errores generales
Preguntas frecuentes
¿Qué significa el error 400?
Un error 400 significa que tu request tiene una entrada no válida. Las causas comunes incluyen una URL mal formada, un formato de media no compatible, campos obligatorios ausentes o un valor fuera del rango permitido. La media que es más larga de lo que permite tu plan se rechaza con 402 generation_plan_duration_exceeded, no con 400. Revisa el código de error concreto en el body de la respuesta para ver qué debes corregir.
¿Por qué mi generación está atascada en PENDING?
Una generación en estado PENDING está esperando recursos de procesamiento. En periodos de alta demanda, los jobs pueden quedar brevemente en cola antes de empezar. Si una generación sigue en PENDING durante mucho tiempo, haz polling de su ID existente o contacta a soporte. No crees una de reemplazo solo porque sigue pendiente.
¿Cómo reintento las generaciones fallidas?
Cuando una generación termina en FAILED o REJECTED, reintenta con la misma clave y las mismas entradas: el reintento inicia una generación nueva, que se admite y se factura como un primer request. Ante un timeout o un resultado de envío desconocido, conserva la clave y las entradas originales; no inicies un reemplazo. Consulta Idempotent Requests.